กรณีศึกษา ลดเวลาร่างรายงานฉบับแรกลง 60%
องค์กรบริการมืออาชีพขนาด 400 คน เปลี่ยนการทดลอง AI ที่กระจัดกระจายให้กลายเป็นเวิร์กโฟลว์ที่วัดผลได้และทำซ้ำได้อย่างไร
องค์กรบริการมืออาชีพขนาดราว 400 คน มีภาพที่คุ้นเคย: ผู้ใช้ระดับเชี่ยวชาญไม่กี่คนทำสิ่งที่น่าประทับใจด้วย AI ส่วนที่เหลือได้แต่มองดู1 การเขียนรายงาน — งานส่งมอบหลักที่กินเวลามาก — คนส่วนใหญ่ในทีมยังทำแบบเดิม1กรณีนี้เป็นกรณีรวม ที่ถอดระบุตัวตนและสรุปจากงานของ Fellow หลายโครงการ ตัวเลขเป็นตัวแทนของสิ่งที่เราวัดได้ในรูปแบบนี้ ไม่ใช่ผลที่ตรวจสอบแล้วของลูกค้ารายใดรายหนึ่ง
พาร์ตเนอร์ที่ติดต่อเรามาอธิบายว่าเป็นปัญหาการอบรม สิบสองเดือนและเวิร์กช็อปจากผู้ขายสองครั้งต่อมา องค์กรมีไลเซนส์ให้ทุกคนและมีกราฟการใช้งานที่หน้าตาเหมือนยอดแหลมเดียวในสัปดาห์แรก
สถานการณ์
มีสามเรื่องที่เป็นจริงพร้อมกัน และควรแยกออกจากกัน เพราะมักถูกยุบรวมเป็น "การนำไปใช้ช้า"
คนเข้าใจเครื่องมือ ไม่มีใครต้องถูกโน้มน้าวว่าโมเดลภาษาร่างส่วนหนึ่งของรายงานได้ ความกังขาแคบกว่านั้นและมีเหตุผลรองรับดีกว่านั้น: พวกเขาไม่เชื่อว่าส่วนที่ AI ร่างจะผ่านการตรวจทานของบริษัทได้ โดยไม่เสียเวลาแก้มากกว่าเวลาที่ประหยัดได้จากการร่าง
ผู้ใช้ระดับเชี่ยวชาญมีเวิร์กโฟลว์ที่ดีจริง และไม่มีอันใดถูกเขียนบันทึกไว้ แต่ละคนในสี่ห้าคนที่ทำงานได้น่าประทับใจ ต่างสร้างชุดพรอมป์ตและนิสัยของตัวเองไว้ในแอปโน้ตส่วนตัว ไม่มีอะไรถูกแบ่งปัน จึงไม่มีอะไรทบต้น◦บทความที่เกี่ยวข้องเปลี่ยนชัยชนะรายบุคคลให้เป็นขีดความสามารถขององค์กร
และคุณภาพรายงานคือตัวสินค้าของบริษัท นี่คือข้อจำกัดที่ทำให้ธุรกิจบริการมืออาชีพต่างจากเรื่องเล่าการนำ AI ไปใช้ส่วนใหญ่: งานส่งมอบที่แย่ไม่ใช่ความไม่สะดวก แต่คือสิ่งที่ลูกค้าจ่ายเงินเพื่อไม่ให้ได้รับ
เรื่องนี้ไม่ใช่ปัญหาเฉพาะที่
การร่างรายงานเป็นหนึ่งในไม่กี่กรณีการใช้ AI ที่มีหลักฐานเชิงทดลองหนุนแข็ง ซึ่งเป็นเหตุผลใหญ่ที่เราเลือกมันเป็นเป้าหมายแรก
งานวิจัยของ Noy และ Zhang ปี 2023 ในวารสาร Science ให้มืออาชีพ 453 คนทำงานเขียนระดับกลาง พบว่าเวลาที่ใช้ลดลงราว 40% ขณะที่คุณภาพผลงานเพิ่มขึ้นราว 18% และยังพบสิ่งที่มีประโยชน์กว่านั้นต่อการขยายผล: ช่องว่างระหว่างนักเขียนที่เก่งกว่ากับที่อ่อนกว่าแคบลง1◦2แหล่งอ้างอิงNoy & Zhang, Science, 2023 (ผ่าน MIT News)ตัวเลข−40% / +18%เวลาที่ใช้เขียนและคุณภาพที่เปลี่ยนไป จากมืออาชีพ 453 คน — Noy และ Zhang วารสาร Science ปี 20232งานเหล่านี้เป็นงานแบบห้องทดลองที่มีสิ่งจูงใจ ไม่ใช่งานส่งมอบลูกค้าจริง จึงควรอ่านทิศทางว่าหนักแน่น แต่อ่านขนาดของผลว่าค่อนข้างใจกว้าง
Dell'Acqua และคณะ ในงานวิจัยขอบเขตขยักปี 2023 ที่ทำกับที่ปรึกษา BCG 758 คน พบว่างานเสร็จเร็วขึ้น 25.1% และคุณภาพสูงขึ้นกว่า 40% ในขอบเขตที่ AI ทำได้ และผู้ที่ทำได้ต่ำกว่าค่าเฉลี่ยดีขึ้น 43% เทียบกับ 17% ในกลุ่มที่สูงกว่าค่าเฉลี่ย งานวิจัย NBER ของ Brynjolfsson, Li และ Raymond จากพนักงานซัพพอร์ตกว่า 5,000 คนพบรูปร่างเดียวกัน: +14% โดยรวม +34% ในกลุ่มมือใหม่ และแทบไม่มีผลในกลุ่มที่มีประสบการณ์มากที่สุด2แหล่งอ้างอิงBrynjolfsson, Li & Raymond, "Generative AI at Work", NBER WP 31161, 2023
ข้อค้นพบที่สอดคล้องกันในทั้งสามงานคือ งานลักษณะนี้ถูกบีบอัดมากที่สุดสำหรับคนที่ปัจจุบันทำมันได้ช้าที่สุด นั่นคือเหตุผลที่ควรเล็งเวิร์กโฟลว์การร่างไปที่ตรงกลางของบริษัท ไม่ใช่ที่ระดับพาร์ตเนอร์◦ภาพประกอบ ผลลัพธ์กระจุกอยู่ที่จุดที่การร่างช้าที่สุด — ตรงกลางของบริษัท ไม่ใช่ยอดบนสุด
หลักฐานฝ่ายตรงข้ามสำคัญไม่แพ้กัน และมันมาจากอุตสาหกรรมนี้เอง เดือนตุลาคม 2025 Deloitte Australia คืนเงินส่วนหนึ่งของสัญญามูลค่า 440,000 ดอลลาร์ออสเตรเลียกับกระทรวงแรงงานและความสัมพันธ์ในที่ทำงาน หลังพบว่ารายงานที่ส่งมอบมีการอ้างอิงที่ AI สร้างขึ้นเอง รวมถึงข้อความอ้างอิงที่ถูกกุขึ้นและระบุว่ามาจากคำพิพากษาศาลกลาง3 ในคดี Mata v. Avianca ปี 2023 ทนายความนิวยอร์กสองคนและสำนักงานของพวกเขาถูกลงโทษปรับ 5,000 ดอลลาร์ จากคำฟ้องที่สร้างบนการอ้างอิงคดีที่ ChatGPT กุขึ้น4แหล่งอ้างอิงDeloitte Australia's partial refund on an AI-error report, 2025 (ผ่าน CFO Dive)แหล่งอ้างอิงMata v. Avianca, Inc., 2023
ทั้งสองกรณีคือความล้มเหลวแบบเดียวกัน: ข้อความที่ AI ร่างเข้าไปอยู่ในงานส่งมอบลูกค้า โดยไม่มีขั้นตอนตรวจทานที่ออกแบบมาเพื่อจับการกุขึ้นจริง ๆ กลุ่มที่กังขาในบริษัทคิดถูกเรื่องความเสี่ยง แต่คิดผิดที่เชื่อว่าคำตอบคือการหลีกเลี่ยงเครื่องมือ
ทำไมการอบรมเพิ่มจึงเป็นทางที่ผิด
สัญชาตญาณหลังเห็นกราฟการใช้งานราบเรียบคือจัดอบรมให้ดีขึ้น เราเห็นสิ่งนี้ล้มเหลวมามากพอที่จะระบุสาเหตุได้
การอบรมทั่วไปสอนเรื่องเครื่องมือ แต่กำแพงในที่นี้ไม่ใช่เครื่องมือ Work Trend Index ของ Microsoft ปี 2024 พบว่ามีเพียง 39% ของผู้ใช้ AI ที่ได้รับการอบรมจากบริษัท5 — แต่การศึกษาของ BCG ปี 2025 จากพนักงาน 10,600 คน พบว่าแม้ในกลุ่มที่ได้รับการอบรมแล้ว มีเพียงราวหนึ่งในสามที่รู้สึกว่าถูกเตรียมพร้อมอย่างเหมาะสม การเพิ่มชั่วโมงของเนื้อหาเดิมไม่ได้เปลี่ยนใจคนที่ข้อคัดค้านจริงคือ "สิ่งนี้จะไม่รอดการตรวจทาน"6แหล่งอ้างอิงMicrosoft, 2024 Work Trend Indexแหล่งอ้างอิงBCG, "AI at Work 2025"
การประเมินความรู้ด้าน AI ทำให้เรื่องนี้เป็นรูปธรรม◦ พื้นฐานได้คะแนนสูง การผนวกเข้าเวิร์กโฟลว์ได้คะแนนต่ำ วิจารณญาณอยู่กลาง ๆ ด้วยการกระจายตัวที่กว้าง พูดอีกอย่าง: พวกเขารู้ว่าเครื่องมือคืออะไร บางคนรู้ว่าเมื่อไรควรไม่เชื่อผลลัพธ์ และแทบไม่มีใครถักทอสองสิ่งนั้นเข้ากับงานส่งมอบ หลักสูตรที่แก้เรื่องพื้นฐานคงได้สอนบริษัทสิ่งที่บริษัทรู้อยู่แล้วบทความที่เกี่ยวข้องการประเมินนั้นทำงานอย่างไร
การร่างรายงานจึงเป็นเป้าหมายแรกที่ชัดเจน — ปริมาณมาก ใช้เวลาสูง โครงสร้างสม่ำเสมอ และมีมาตรฐานคุณภาพที่เขียนไว้เป็นลายลักษณ์อักษรอยู่แล้ว
สิ่งที่เราทำ ตามลำดับ
หกสัปดาห์ ใช้เวลาของ Fellow ราวห้าคน-สัปดาห์ และของบริษัทอีกราวเท่ากัน
สัปดาห์ที่ 1: วางค่าพื้นฐานอย่างตรงไปตรงมา เราจับเวลาการร่างฉบับแรกในสามกลุ่มงานก่อนจะแตะอะไรทั้งนั้น นี่เป็นส่วนที่คนชอบน้อยที่สุดในโครงการ — การจับเวลางานตัวเองให้ความรู้สึกเหมือนถูกสอดส่อง และสองในสามกลุ่มคัดค้านหนัก สิ่งที่คลี่คลายได้คือการรายงานผลเป็นกลุ่มไม่ใช่รายบุคคล และการประกาศเรื่องนี้ก่อนเก็บข้อมูลใด ๆ◦ ถ้าไม่มีค่าพื้นฐานนั้น เราจะไม่มีตัวเลขที่ปกป้องได้ในตอนท้าย และโครงการก็จะถูกรื้อถกใหม่ในรอบงบประมาณถัดไปนิยามค่าพื้นฐาน การวัดก่อนเริ่ม ที่คุณใช้เปรียบเทียบผลลัพธ์ ถ้าไม่มีมัน ทุกคำกล่าวอ้างเรื่องความก้าวหน้าหลังจากนั้นก็เป็นเพียงการอ้าง
สัปดาห์ที่ 2–3: ร่วมสร้างคลังพรอมป์ต ไม่ใช่เขียนให้ทีม แต่เขียนกับทีม ในเซสชันที่พาร์ตเนอร์เอารายงานจริงมาวางแล้วเราสร้างพรอมป์ตกับมันสด ๆ คลังนี้ถูกปรับให้เข้ากับรูปแบบรายงานจริงและโทนของบริษัท◦ รายละเอียดที่ไม่หวือหวาแต่สำคัญที่สุดคือ มันอยู่ในที่ที่คนทำงานอยู่แล้ว ไม่ใช่ในเครื่องมือใหม่ที่ต้องล็อกอินใหม่นิยามคลังพรอมป์ต ชุดพรอมป์ตที่ใช้ร่วมกันและดูแลต่อเนื่อง ปรับให้เข้ากับรูปแบบและโทนขององค์กร มีผู้รับผิดชอบชัดเจน
สัปดาห์ที่ 3: เช็กลิสต์ตรวจทาน ที่เกือบไม่ได้เกิด นี่คือชิ้นที่มีข้อโต้แย้ง ฝั่งการร่างของเวิร์กโฟลว์ได้รับความนิยมทันที แต่การบังคับตรวจส่วนที่ AI ร่าง ถูกหลายคนอ่านว่าเป็นการประกาศว่าวิจารณญาณของเขาไม่ได้รับความเชื่อถือ มันอยู่รอดได้เพราะเราจำกัดขอบเขตให้เหลือเพียงสองรูปแบบความผิดพลาดที่เกิดขึ้นจริง — การอ้างอิงที่กุขึ้น และรายละเอียดเฉพาะที่ผิดอย่างมั่นใจ — แทนที่จะเป็นด่านตรวจคุณภาพแบบทั่วไป และเพราะคนที่แนะนำมันคือพาร์ตเนอร์ ไม่ใช่ที่ปรึกษา
มองย้อนกลับไป นี่คือองค์ประกอบที่สำคัญที่สุดในโครงการ และเราเกือบยอมแลกมันไปเพื่อรักษาบรรยากาศในห้อง
สัปดาห์ที่ 4–5: ผู้รับผิดชอบที่ระบุชื่อ หนึ่งคนต่อหนึ่งกลุ่มงาน รับผิดชอบดูแลคลังและโค้ชเพื่อนร่วมงาน โดยเขียนบทบาทนี้ไว้ในเป้าหมายงานของเขาพร้อมตัวสำรองที่ระบุชื่อ◦ หนึ่งในสามผู้รับผิดชอบเดิมย้ายออกจากบทบาทภายในสี่เดือน ตัวสำรองคือเหตุผลที่เรื่องนั้นไม่ปรากฏเป็นการใช้งานที่ลดลง◦ภาพประกอบ เวิร์กโฟลว์อยู่กับกลุ่มงาน ไม่ใช่กับที่ปรึกษาบทความที่เกี่ยวข้องอะไรเปลี่ยนไปเมื่อการนำไปใช้มีเจ้าภาพที่ระบุชื่อได้
สัปดาห์ที่ 6: ติดตั้งการวัดและส่งมอบ การอ่านผลการใช้งานจริงและเวลาการร่างรายเดือน โดยมีหัวหน้าฝ่ายปฏิบัติการของบริษัทเป็นเจ้าของ — เจตนาเลือกคนที่งานหลักไม่ใช่ AI
อะไรเปลี่ยนไปในหนึ่งไตรมาส
เวลาเฉลี่ยในการร่างรายงานมาตรฐานฉบับแรกลดลงราว 60%◦ตัวเลข≈60%เวลาเฉลี่ยในการร่าง ฉบับแรก ที่ลดลงในหนึ่งไตรมาส — ไม่ใช่เวลารวมจนได้รายงานที่พร้อมส่งลูกค้า
มีสองข้อกำกับที่ต้องอยู่ติดกับตัวเลขนั้นทันที มันคือเวลาการร่างฉบับแรก ไม่ใช่เวลารวมทั้งวงจร: การตรวจทานและการอนุมัติของพาร์ตเนอร์ไม่ได้ถูกบีบลงมากเท่านั้น และเวลารวมจนได้รายงานที่พร้อมส่งลูกค้าลดลงใกล้เคียงหนึ่งในสี่ และมันเป็นตัวเลขรวมจากหลายโครงการที่แสดงรูปแบบนี้ ไม่ใช่ผลที่ตรวจสอบแล้วของบริษัทเดียว
การใช้งานยังคงอยู่ ซึ่งสำคัญกว่าตัวเลขเปอร์เซ็นต์3 สามเดือนหลังจบงาน การใช้งานไม่ได้ลดถอย เหตุผลเป็นเรื่องโครงสร้างมากกว่าวัฒนธรรม: เวิร์กโฟลว์เป็นของกลุ่มงาน คลังมีผู้ดูแล และการอ่านผลรายเดือนมีเจ้าของที่ยังอยู่3"คงอยู่" คือหัวใจทั้งหมด — เวิร์กโฟลว์เป็นของทีม จึงอยู่รอดแม้เราจากไป สิ่งที่เราถูกเรียกไปแก้ส่วนใหญ่คือชัยชนะที่เสื่อมสลายจากโครงการก่อนหน้า
เช็กลิสต์ตรวจทานจับการอ้างอิงที่กุขึ้นได้สองครั้งในไตรมาสแรก ไม่มีอันใดไปถึงลูกค้า นั่นคือตัวเลขที่พาร์ตเนอร์พูดถึงจริง ๆ
บทเรียนนี้เกิดซ้ำในทุกงาน: การนำไปใช้เดินตามเวิร์กโฟลว์ที่เจาะจงและมีเจ้าของ ได้แน่นอนกว่าการเดินตามเครื่องมือที่ดี
สิ่งที่เราจะทำต่างไป
เราจะสร้างขั้นตอนตรวจทานก่อน เราสร้างการร่างก่อนเพราะเป็นชัยชนะที่ง่ายและซื้อความน่าเชื่อถือให้เรา แต่สำหรับบริษัทที่ตัวสินค้าคืองานส่งมอบ ขั้นตอนตรวจทานคือส่วนที่รับน้ำหนัก และการมองว่าเป็นเรื่องของเฟสสองเกือบทำให้เราเสียมันไปทั้งหมด จงเริ่มที่จุดที่ความเสี่ยงอยู่ แล้วค่อยไปเก็บผลของการร่างทีหลัง
เราลงทุนกับเรื่องขอบเขตขยักน้อยเกินไป คลังพรอมป์ตทำให้คนเร็วขึ้นในส่วนของรายงานที่คล้ายกับรายงานอื่น มันไม่ได้ให้อะไรกับงานที่ใหม่จริง ๆ — และนั่นคือจุดที่ข้อค้นพบของ Dell'Acqua กัด: ในงานที่อยู่นอกความสามารถของ AI ที่ปรึกษาที่ใช้มันมีโอกาสตอบถูกน้อยกว่าถึง 19 จุดเปอร์เซ็นต์◦ คลังพรอมป์ตที่ดีสอนคนอย่างเงียบ ๆ ว่าเครื่องมือนี้เชื่อถือได้ เราควรจับคู่มันกับคำแนะนำที่ชัดเจนว่าเมื่อไรควรปิดมัน7ตัวเลข−19 จุดโอกาสตอบถูกที่ลดลงของที่ปรึกษาที่ใช้ AI ในงานที่อยู่นอกความสามารถของ AI — Dell'Acqua และคณะ ปี 2023แหล่งอ้างอิงDell'Acqua et al., "Navigating the Jagged Technological Frontier", 2023
60% เป็นพาดหัวที่ผิดสำหรับการสื่อสารภายใน มันเดินทางได้ดีและทำให้โครงการรู้สึกว่าเสร็จแล้ว ไตรมาสต่อมา ความสนใจของบริษัทย้ายไปที่อื่น ขณะที่เวลาการตรวจทาน — ซึ่งตอนนี้คือข้อจำกัดจริง — ไม่ถูกพิจารณา ถ้าทำใหม่ ตัวชี้วัดที่รายงานจะเป็นเวลารวมจนได้รายงานที่พร้อมส่งลูกค้าตั้งแต่ต้น แม้ตัวเลขจะดูน่าประทับใจน้อยกว่ามาก
คลังพรอมป์ตต้องมีวันทบทวน ไม่ใช่แค่มีผู้ดูแล โมเดลเปลี่ยน พรอมป์ตที่ปรับเข้ากับนิสัยของโมเดลหนึ่งจะแก่ตัวไปเป็นทางเลี่ยงของปัญหาที่ไม่มีอยู่แล้ว ความเป็นเจ้าของทำให้คลังมีชีวิต แต่มีเพียงการทบทวนตามกำหนดที่ทำให้มันยังถูกต้อง
สิ่งที่ควรหยิบไปใช้
- วางค่าพื้นฐานก่อนสร้าง รายงานเป็นกลุ่ม และประกาศก่อนเก็บข้อมูล ไม่มีค่าพื้นฐาน ก็ไม่มีตัวเลขที่ปกป้องได้
- เลือกงานส่งมอบที่มีปริมาณมาก โครงสร้างสม่ำเสมอ และมีมาตรฐานคุณภาพที่เขียนไว้แล้ว
- สร้างขั้นตอนตรวจทานสำหรับสองรูปแบบความผิดพลาดที่เกิดขึ้นจริง — แหล่งอ้างอิงที่กุขึ้นและรายละเอียดที่ผิดอย่างมั่นใจ — ไม่ใช่ด่านตรวจคุณภาพแบบทั่วไป การตรวจที่แคบคือการตรวจที่ถูกใช้
- ให้พาร์ตเนอร์เป็นคนแนะนำการตรวจ ไม่ใช่ที่ปรึกษา
- ตั้งผู้รับผิดชอบต่อกลุ่ม เขียนไว้ในเป้าหมายงาน และระบุตัวสำรอง คุณจะต้องใช้ตัวสำรองนั้น
- รายงานตัวชี้วัดที่สะท้อนข้อจำกัดจริง แม้จะมีตัวเลขที่ฟังดูดีกว่าให้เลือก
- ให้คลังมีวันทบทวน สิ่งที่มีเจ้าของก็ยังเก่าได้◦บทความที่เกี่ยวข้องระบบการขยายผลต้องมีอะไรเพื่อให้อยู่รอด
New Version
องค์กรบริการมืออาชีพขนาดราว 400 คน มีภาพที่คุ้นเคย คือมีผู้ใช้ระดับเชี่ยวชาญไม่กี่คนที่ทำสิ่งน่าประทับใจด้วย AI ส่วนคนที่เหลือได้แต่มองดู4 ส่วนการเขียนรายงาน ซึ่งเป็นงานส่งมอบหลักที่กินเวลามาก คนส่วนใหญ่ในทีมก็ยังทำแบบเดิม4กรณีนี้เป็นกรณีรวมที่ถอดระบุตัวตน โดยสรุปจากงานของ Fellow หลายโครงการ ตัวเลขจึงเป็นตัวแทนของสิ่งที่เราวัดได้ในรูปแบบนี้ ไม่ใช่ผลที่ตรวจสอบแล้วของลูกค้ารายใดรายหนึ่ง
พาร์ตเนอร์ที่ติดต่อเรามาอธิบายว่านี่คือปัญหาการอบรม สิบสองเดือนกับเวิร์กช็อปจากผู้ขายอีกสองครั้งต่อมา องค์กรได้ไลเซนส์ครบทุกคน และได้กราฟการใช้งานที่มีเพียงยอดแหลมเดียวในสัปดาห์แรก
สถานการณ์
มีสามเรื่องที่เป็นจริงพร้อมกัน และควรแยกออกจากกันให้ชัด เพราะทั้งสามมักถูกยุบรวมเป็นคำเดียวว่า "การนำไปใช้ช้า"
คนที่นี่เข้าใจเครื่องมือดีอยู่แล้ว ไม่มีใครต้องถูกโน้มน้าวว่าโมเดลภาษาช่วยร่างรายงานบางส่วนได้ ความกังขาของพวกเขาแคบกว่านั้น และมีเหตุผลรองรับดีกว่านั้นด้วย คือพวกเขาไม่เชื่อว่าส่วนที่ AI ร่างจะผ่านการตรวจทานของบริษัทไปได้ โดยไม่ต้องเสียเวลาแก้มากกว่าเวลาที่ประหยัดได้จากการร่าง
ผู้ใช้ระดับเชี่ยวชาญมีเวิร์กโฟลว์ที่ดีจริง แต่ไม่มีสักอันที่ถูกเขียนบันทึกไว้ สี่ห้าคนที่ทำงานออกมาน่าประทับใจ ต่างคนต่างสะสมชุดพรอมป์ตและวิธีทำงานของตัวเองไว้ในแอปโน้ตส่วนตัว เมื่อไม่มีอะไรถูกแบ่งปัน ก็ไม่มีอะไรทบต้น◦บทความที่เกี่ยวข้องเปลี่ยนชัยชนะรายบุคคลให้เป็นขีดความสามารถขององค์กร
และคุณภาพของรายงานก็คือตัวสินค้าของบริษัท นี่คือข้อจำกัดที่ทำให้ธุรกิจบริการมืออาชีพต่างจากเรื่องเล่าการนำ AI ไปใช้ส่วนใหญ่ เพราะงานส่งมอบที่แย่ไม่ใช่เรื่องความไม่สะดวก แต่คือสิ่งที่ลูกค้าจ่ายเงินเพื่อไม่ให้ได้รับ
เรื่องนี้ไม่ใช่ปัญหาเฉพาะที่
การร่างรายงานเป็นหนึ่งในไม่กี่กรณีการใช้ AI ที่มีหลักฐานเชิงทดลองหนุนหลังอย่างหนักแน่น และนั่นคือเหตุผลใหญ่ที่เราเลือกมันเป็นเป้าหมายแรก
งานวิจัยของ Noy และ Zhang ปี 2023 ในวารสาร Science ให้มืออาชีพ 453 คนทำงานเขียนระดับกลาง ผลคือเวลาที่ใช้ลดลงราว 40% ขณะที่คุณภาพของงานเพิ่มขึ้นราว 18% และยังมีข้อค้นพบอีกอย่างที่เป็นประโยชน์ต่อการขยายผลมากกว่านั้น คือช่องว่างระหว่างนักเขียนที่เก่งกว่ากับนักเขียนที่อ่อนกว่าแคบลง1◦5แหล่งอ้างอิงNoy & Zhang, Science, 2023 (ผ่าน MIT News)ตัวเลข−40% / +18%เวลาที่ใช้เขียนและคุณภาพที่เปลี่ยนไป จากมืออาชีพ 453 คน (Noy และ Zhang วารสาร Science ปี 2023)5งานเหล่านี้เป็นงานแบบห้องทดลองที่มีสิ่งจูงใจ ไม่ใช่งานส่งมอบลูกค้าจริง จึงควรอ่านว่าทิศทางหนักแน่น แต่ขนาดของผลค่อนข้างใจกว้าง
Dell'Acqua และคณะ ในงานวิจัยเรื่องขอบเขตขยักปี 2023 ที่ทำกับที่ปรึกษา BCG จำนวน 758 คน พบว่างานเสร็จเร็วขึ้น 25.1% และคุณภาพสูงขึ้นกว่า 40% ในขอบเขตที่ AI ทำได้ โดยกลุ่มที่เดิมทำได้ต่ำกว่าค่าเฉลี่ยดีขึ้น 43% เทียบกับ 17% ในกลุ่มที่สูงกว่าค่าเฉลี่ย ส่วนงานวิจัย NBER ของ Brynjolfsson, Li และ Raymond ที่เก็บจากพนักงานซัพพอร์ตกว่า 5,000 คน ให้ภาพรูปร่างเดียวกัน คือ +14% โดยรวม +34% ในกลุ่มมือใหม่ และแทบไม่ขยับเลยในกลุ่มที่มีประสบการณ์มากที่สุด2แหล่งอ้างอิงBrynjolfsson, Li & Raymond, "Generative AI at Work", NBER WP 31161, 2023
สิ่งที่ทั้งสามงานพูดตรงกันคือ งานลักษณะนี้ถูกบีบเวลาลงมากที่สุดในมือของคนที่ตอนนี้ทำมันได้ช้าที่สุด นั่นคือเหตุผลที่เวิร์กโฟลว์การร่างควรเล็งไปที่ตรงกลางของบริษัท ไม่ใช่ที่ระดับพาร์ตเนอร์◦ภาพประกอบผลลัพธ์กระจุกอยู่ที่จุดที่การร่างช้าที่สุด คือตรงกลางของบริษัท ไม่ใช่ยอดบนสุด
หลักฐานอีกฝั่งสำคัญไม่แพ้กัน และมันมาจากอุตสาหกรรมนี้เอง เดือนตุลาคม 2025 Deloitte Australia คืนเงินบางส่วนของสัญญามูลค่า 440,000 ดอลลาร์ออสเตรเลียกับกระทรวงแรงงานและความสัมพันธ์ในที่ทำงาน หลังพบว่ารายงานที่ส่งมอบมีการอ้างอิงที่ AI สร้างขึ้นเอง รวมถึงข้อความอ้างอิงที่ถูกกุขึ้นแล้วระบุว่ามาจากคำพิพากษาศาลกลาง3 ส่วนในคดี Mata v. Avianca ปี 2023 ทนายความนิวยอร์กสองคนกับสำนักงานของพวกเขาถูกลงโทษปรับ 5,000 ดอลลาร์ จากคำฟ้องที่สร้างขึ้นบนการอ้างอิงคดีที่ ChatGPT กุขึ้นมา4แหล่งอ้างอิงDeloitte Australia's partial refund on an AI-error report, 2025 (ผ่าน CFO Dive)แหล่งอ้างอิงMata v. Avianca, Inc., 2023
ทั้งสองกรณีคือความล้มเหลวแบบเดียวกัน คือข้อความที่ AI ร่างหลุดเข้าไปอยู่ในงานส่งมอบลูกค้า โดยไม่มีขั้นตอนตรวจทานที่ออกแบบมาเพื่อจับการกุขึ้นโดยเฉพาะ คนกลุ่มที่กังขาในบริษัทจึงคิดถูกเรื่องความเสี่ยง แต่คิดผิดตรงที่เชื่อว่าคำตอบคือการหลีกเลี่ยงเครื่องมือ
ทำไมการอบรมเพิ่มจึงเป็นทางที่ผิด
สัญชาตญาณแรกเมื่อเห็นกราฟการใช้งานราบเรียบคือจัดอบรมให้ดีขึ้น เราเห็นทางนี้ล้มเหลวมามากพอจะบอกได้ว่ามันล้มเหลวเพราะอะไร
การอบรมทั่วไปสอนเรื่องเครื่องมือ แต่กำแพงตรงนี้ไม่ใช่เครื่องมือ Work Trend Index ของ Microsoft ปี 2024 พบว่ามีเพียง 39% ของผู้ใช้ AI ที่ได้รับการอบรมจากบริษัท5 ขณะที่การศึกษาของ BCG ปี 2025 จากพนักงาน 10,600 คน พบว่าแม้แต่ในกลุ่มที่ผ่านการอบรมมาแล้ว ก็มีเพียงราวหนึ่งในสามที่รู้สึกว่าตัวเองถูกเตรียมพร้อมมาอย่างเหมาะสม การเพิ่มชั่วโมงให้เนื้อหาชุดเดิมจึงไม่ได้เปลี่ยนใจคนที่ข้อคัดค้านจริง ๆ คือ "สิ่งนี้จะไม่รอดการตรวจทาน"6แหล่งอ้างอิงMicrosoft, 2024 Work Trend Indexแหล่งอ้างอิงBCG, "AI at Work 2025"
การประเมินความรู้ด้าน AI ทำให้เรื่องนี้เป็นรูปธรรม◦ พื้นฐานได้คะแนนสูง การผนวกเข้ากับเวิร์กโฟลว์ได้คะแนนต่ำ ส่วนวิจารณญาณอยู่กลาง ๆ โดยกระจายตัวกว้างมาก พูดอีกแบบคือ พวกเขารู้ว่าเครื่องมือคืออะไร บางคนรู้ว่าเมื่อไรควรไม่เชื่อผลลัพธ์ แต่แทบไม่มีใครถักทอสองสิ่งนั้นเข้ากับงานส่งมอบได้ หลักสูตรที่ไปแก้เรื่องพื้นฐานจึงมีค่าเท่ากับสอนสิ่งที่บริษัทรู้อยู่แล้วบทความที่เกี่ยวข้องการประเมินนั้นทำงานอย่างไร
การร่างรายงานจึงเป็นเป้าหมายแรกที่ชัดเจน คือมีปริมาณมาก ใช้เวลาสูง โครงสร้างสม่ำเสมอ และมีมาตรฐานคุณภาพที่เขียนไว้เป็นลายลักษณ์อักษรอยู่แล้ว
สิ่งที่เราทำ ตามลำดับ
หกสัปดาห์ ใช้เวลาของ Fellow ราวห้าคน-สัปดาห์ และเวลาของบริษัทอีกราวเท่ากัน
สัปดาห์ที่ 1: วางค่าพื้นฐานอย่างตรงไปตรงมา เราจับเวลาการร่างฉบับแรกในสามกลุ่มงานก่อนจะไปแตะอะไรทั้งนั้น นี่คือส่วนที่คนชอบน้อยที่สุดของโครงการ เพราะการจับเวลางานตัวเองให้ความรู้สึกเหมือนถูกสอดส่อง และสองในสามกลุ่มคัดค้านหนัก สิ่งที่คลี่คลายมันได้คือการรายงานผลเป็นระดับกลุ่มไม่ใช่รายบุคคล และการประกาศเรื่องนี้ให้ชัดก่อนเก็บข้อมูลใด ๆ◦ ถ้าไม่มีค่าพื้นฐานนั้น เราจะไม่มีตัวเลขที่ปกป้องตัวเองได้ในตอนท้าย และโครงการก็จะถูกรื้อขึ้นมาถกใหม่ในรอบงบประมาณถัดไปนิยามค่าพื้นฐาน การวัดก่อนเริ่มที่คุณใช้เป็นหลักเทียบผลลัพธ์ ถ้าไม่มีมัน ทุกคำกล่าวอ้างเรื่องความก้าวหน้าหลังจากนั้นก็เป็นได้แค่คำกล่าวอ้าง
สัปดาห์ที่ 2–3: ร่วมสร้างคลังพรอมป์ต ไม่ใช่เขียนให้ทีม แต่เขียนไปด้วยกันกับทีม ในเซสชันที่พาร์ตเนอร์หยิบรายงานจริงมาวางบนโต๊ะ แล้วเราสร้างพรอมป์ตกับมันสด ๆ ตรงนั้น คลังนี้จึงถูกปรับให้เข้ากับรูปแบบรายงานจริงและโทนของบริษัท◦ รายละเอียดที่ไม่หวือหวาแต่สำคัญที่สุดคือ มันอยู่ในที่ที่คนทำงานอยู่แล้ว ไม่ใช่ในเครื่องมือใหม่ที่ต้องล็อกอินใหม่นิยามคลังพรอมป์ต ชุดพรอมป์ตที่ใช้ร่วมกันและดูแลต่อเนื่อง ปรับให้เข้ากับรูปแบบและโทนขององค์กร มีผู้รับผิดชอบชัดเจน
สัปดาห์ที่ 3: เช็กลิสต์ตรวจทานที่เกือบไม่ได้เกิด นี่คือชิ้นที่มีข้อโต้แย้ง ฝั่งการร่างของเวิร์กโฟลว์ได้รับความนิยมทันที แต่การบังคับตรวจส่วนที่ AI ร่าง ถูกหลายคนอ่านว่าเป็นการประกาศว่าวิจารณญาณของพวกเขาไม่ได้รับความเชื่อถือ มันรอดมาได้เพราะเราจำกัดขอบเขตให้เหลือเพียงสองรูปแบบความผิดพลาดที่เกิดขึ้นจริง คือการอ้างอิงที่กุขึ้น กับรายละเอียดเฉพาะที่ผิดอย่างมั่นใจ แทนที่จะทำเป็นด่านตรวจคุณภาพแบบทั่วไป และเพราะคนที่แนะนำมันคือพาร์ตเนอร์ ไม่ใช่ที่ปรึกษา
มองย้อนกลับไป นี่คือองค์ประกอบที่สำคัญที่สุดของโครงการ และเราเกือบยอมแลกมันทิ้งไปเพื่อรักษาบรรยากาศในห้อง
สัปดาห์ที่ 4–5: ผู้รับผิดชอบที่ระบุชื่อ หนึ่งคนต่อหนึ่งกลุ่มงาน ทำหน้าที่ดูแลคลังและโค้ชเพื่อนร่วมงาน โดยเขียนบทบาทนี้ไว้ในเป้าหมายงานของเขา พร้อมระบุชื่อตัวสำรองไว้ด้วย◦ ต่อมาหนึ่งในสามผู้รับผิดชอบชุดแรกย้ายออกจากบทบาทภายในสี่เดือน และตัวสำรองคือเหตุผลที่เรื่องนั้นไม่โผล่ออกมาเป็นการใช้งานที่ลดลง◦ภาพประกอบเวิร์กโฟลว์อยู่กับกลุ่มงาน ไม่ใช่กับที่ปรึกษาบทความที่เกี่ยวข้องอะไรเปลี่ยนไปเมื่อการนำไปใช้มีเจ้าภาพที่ระบุชื่อได้
สัปดาห์ที่ 6: ติดตั้งการวัดและส่งมอบ เป็นการอ่านผลการใช้งานจริงและเวลาการร่างเป็นรายเดือน โดยมีหัวหน้าฝ่ายปฏิบัติการของบริษัทเป็นเจ้าของ ซึ่งเราเลือกคนที่งานหลักไม่ใช่ AI อย่างตั้งใจ
อะไรเปลี่ยนไปในหนึ่งไตรมาส
เวลาเฉลี่ยในการร่างรายงานมาตรฐานฉบับแรกลดลงราว 60%◦ตัวเลข≈60%เวลาเฉลี่ยในการร่าง ฉบับแรก ที่ลดลงในหนึ่งไตรมาส ไม่ใช่เวลารวมจนได้รายงานที่พร้อมส่งลูกค้า
มีข้อกำกับสองข้อที่ต้องอยู่ติดกับตัวเลขนั้นทันที ข้อแรก นี่คือเวลาการร่างฉบับแรก ไม่ใช่เวลารวมทั้งวงจร เพราะการตรวจทานและการอนุมัติของพาร์ตเนอร์ไม่ได้ถูกบีบลงมากเท่ากัน เวลารวมจนได้รายงานที่พร้อมส่งลูกค้าจึงลดลงใกล้เคียงหนึ่งในสี่ ข้อสอง มันเป็นตัวเลขรวมจากหลายโครงการที่แสดงรูปแบบเดียวกันนี้ ไม่ใช่ผลที่ตรวจสอบแล้วของบริษัทใดบริษัทหนึ่ง
การใช้งานยังคงอยู่ ซึ่งสำคัญกว่าตัวเลขเปอร์เซ็นต์6 สามเดือนหลังจบงาน การใช้งานไม่ได้ลดถอยลง และเหตุผลเป็นเรื่องโครงสร้างมากกว่าวัฒนธรรม เวิร์กโฟลว์เป็นของกลุ่มงาน คลังมีผู้ดูแล และการอ่านผลรายเดือนมีเจ้าของที่ยังอยู่6"คงอยู่" คือหัวใจทั้งหมด เวิร์กโฟลว์เป็นของทีม จึงอยู่รอดได้แม้เราจากไปแล้ว สิ่งที่เราถูกเรียกเข้าไปแก้ส่วนใหญ่คือชัยชนะที่เสื่อมสลายจากโครงการก่อนหน้า
เช็กลิสต์ตรวจทานจับการอ้างอิงที่กุขึ้นได้สองครั้งในไตรมาสแรก และไม่มีอันไหนเล็ดลอดไปถึงลูกค้า นั่นคือตัวเลขที่พาร์ตเนอร์พูดถึงจริง ๆ
บทเรียนนี้เกิดซ้ำในทุกงาน คือการนำไปใช้จะเดินตามเวิร์กโฟลว์ที่เจาะจงและมีเจ้าของ ได้แน่นอนกว่าเดินตามเครื่องมือที่ดี
สิ่งที่เราจะทำต่างไป
เราจะสร้างขั้นตอนตรวจทานก่อน ที่เราทำฝั่งการร่างก่อน เพราะมันเป็นชัยชนะที่ง่ายและซื้อความน่าเชื่อถือให้เราได้ แต่สำหรับบริษัทที่ตัวสินค้าคืองานส่งมอบ ขั้นตอนตรวจทานคือส่วนที่รับน้ำหนักจริง และการมองมันเป็นเรื่องของเฟสสองเกือบทำให้เราเสียมันไปทั้งหมด จงเริ่มที่จุดที่ความเสี่ยงอยู่ แล้วค่อยไปเก็บผลของการร่างทีหลัง
เราลงทุนกับเรื่องขอบเขตขยักน้อยเกินไป คลังพรอมป์ตทำให้คนเร็วขึ้นในส่วนของรายงานที่คล้ายกับรายงานฉบับอื่น แต่ไม่ได้ให้อะไรกับงานที่ใหม่จริง ๆ และนั่นคือจุดที่ข้อค้นพบของ Dell'Acqua กัดเข้าเนื้อ เพราะในงานที่อยู่นอกความสามารถของ AI ที่ปรึกษาที่ใช้มันมีโอกาสตอบถูกน้อยกว่าถึง 19 จุดเปอร์เซ็นต์◦ คลังพรอมป์ตที่ดีจะสอนคนอย่างเงียบ ๆ ว่าเครื่องมือนี้เชื่อถือได้ เราจึงควรจับคู่มันกับคำแนะนำที่ชัดเจนว่าเมื่อไรควรปิดมัน7ตัวเลข−19 จุดโอกาสตอบถูกที่ลดลงของที่ปรึกษาที่ใช้ AI ในงานที่อยู่นอกความสามารถของ AI (Dell'Acqua และคณะ ปี 2023)แหล่งอ้างอิงDell'Acqua et al., "Navigating the Jagged Technological Frontier", 2023
60% เป็นพาดหัวที่ผิดสำหรับการสื่อสารภายใน ตัวเลขนี้เดินทางได้ดี และทำให้โครงการรู้สึกเหมือนเสร็จแล้ว พอถึงไตรมาสถัดมา ความสนใจของบริษัทก็ย้ายไปที่อื่น ขณะที่เวลาการตรวจทาน ซึ่งตอนนี้คือข้อจำกัดจริง กลับไม่ถูกหยิบมาพิจารณา ถ้าทำใหม่ ตัวชี้วัดที่เรารายงานจะเป็นเวลารวมจนได้รายงานที่พร้อมส่งลูกค้าตั้งแต่ต้น แม้ตัวเลขจะดูน่าประทับใจน้อยกว่ามากก็ตาม
คลังพรอมป์ตต้องมีวันทบทวน ไม่ใช่แค่มีผู้ดูแล โมเดลเปลี่ยนไปเรื่อย ๆ พรอมป์ตที่เคยปรับเข้ากับนิสัยของโมเดลหนึ่งจะแก่ตัวลงจนกลายเป็นทางเลี่ยงของปัญหาที่ไม่มีอยู่แล้ว ความเป็นเจ้าของทำให้คลังยังมีชีวิต แต่มีเพียงการทบทวนตามกำหนดเท่านั้นที่ทำให้มันยังถูกต้อง
สิ่งที่ควรหยิบไปใช้
- วางค่าพื้นฐานก่อนลงมือสร้าง รายงานผลเป็นระดับกลุ่ม และประกาศให้รู้ก่อนเก็บข้อมูล ไม่มีค่าพื้นฐาน ก็ไม่มีตัวเลขที่ปกป้องตัวเองได้
- เลือกงานส่งมอบที่มีปริมาณมาก โครงสร้างสม่ำเสมอ และมีมาตรฐานคุณภาพที่เขียนไว้แล้ว
- สร้างขั้นตอนตรวจทานให้ตรงกับสองรูปแบบความผิดพลาดที่เกิดขึ้นจริง คือแหล่งอ้างอิงที่กุขึ้นกับรายละเอียดที่ผิดอย่างมั่นใจ ไม่ใช่ด่านตรวจคุณภาพแบบทั่วไป เพราะการตรวจที่แคบคือการตรวจที่ถูกใช้จริง
- ให้พาร์ตเนอร์เป็นคนแนะนำการตรวจ ไม่ใช่ที่ปรึกษา
- ตั้งผู้รับผิดชอบประจำแต่ละกลุ่มงาน เขียนบทบาทไว้ในเป้าหมายงาน และระบุชื่อตัวสำรอง เพราะสุดท้ายคุณจะได้ใช้ตัวสำรองนั้นแน่
- รายงานตัวชี้วัดที่สะท้อนข้อจำกัดจริง แม้จะมีตัวเลขที่ฟังดูดีกว่าให้เลือก
- กำหนดวันทบทวนคลังไว้ล่วงหน้า เพราะของที่มีเจ้าของก็เก่าได้เหมือนกัน◦บทความที่เกี่ยวข้องระบบการขยายผลต้องมีอะไรเพื่อให้อยู่รอด
แหล่งอ้างอิง
- Noy & Zhang, Science, 2023 (ผ่าน MIT News)
- Brynjolfsson, Li & Raymond, "Generative AI at Work", NBER WP 31161, 2023
- Deloitte Australia's partial refund on an AI-error report, 2025 (ผ่าน CFO Dive)
- Mata v. Avianca, Inc., 2023
- Microsoft, 2024 Work Trend Index
- BCG, "AI at Work 2025"
- Dell'Acqua et al., "Navigating the Jagged Technological Frontier", 2023
อ่านต่อ
กรณีศึกษา: เปลี่ยนชัยชนะ AI รายบุคคล ให้เป็นขีดความสามารถของทั้งทีม
ทีมที่เก่งและผ่านการอบรมมาดี แต่ไม่มีอะไรทบต้น: ชัยชนะ AI ทุกครั้งเป็นของส่วนตัว หลังเก็บเกี่ยวห้าเวิร์กโฟลว์และสร้างผู้ช่วย AI ร่วมกันหนึ่งตัว ผู้ใช้ระดับกลางก็ตามทันคนเก่งสุด
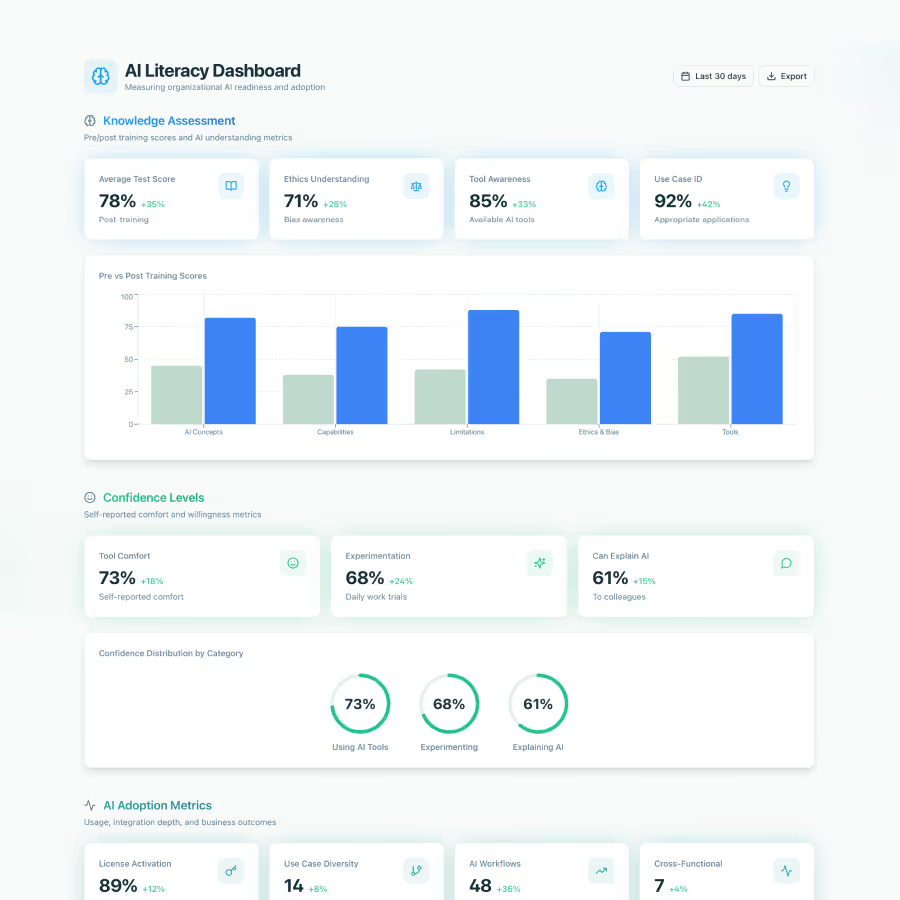
กรณีศึกษา: ทำให้คุณค่าจาก AI มีตัวเลขที่ปกป้องงบประมาณได้
โครงการ AI ที่ทุกคนชอบ เกือบถูกตัดงบ เพราะไม่มีใครพิสูจน์ได้ว่ามันได้ผล หลังวัด baseline ไปสองเวิร์กโฟลว์ มันไม่เพียงรอดจากการถูกตัด แต่ได้งบขยายเพิ่ม